声に表れる認知機能の変化 認知症の早期兆候を捉える2つのアプローチ
1本の電話で認知機能の変化を捉えられるとしたら
「最近、いかがお過ごしですか?」
何気ない日常会話には、単なる安否確認にとどまらない情報が含まれています。認知機能の状態は、「何を話すか」と「どのように話すか」の両方に、微妙な変化として表れるからです。
世界保健機関(WHO)によると、2021年時点で世界の認知症患者は5,700万人に上ります。認知症は早期に発見するほど、適切な介入によって進行を遅らせられる可能性が高まります。しかし、認知機能低下の初期兆候は目立ちにくく、日常生活の中では見過ごされがちです。
認知機能の低下が疑われる場合、脳画像検査や、近年報告されている血液検査などの精密検査が行われます。ただし、いずれも医療機関を受診する必要があり、費用もかかります。こうした検査を受ける前の段階で、電話越しの声から認知機能低下の兆候を継続的に捉えられないでしょうか。
NAVER Cloudは、この問いに答えるため研究を進めてきました。その成果をまとめた2本の論文が、音声分野を代表する国際会議「Interspeech 2026」に採択されました。アプローチは異なるものの、同じ公開データセットで評価したところ、いずれも発表時点の最高性能を上回り、同じスコアを記録しました。
1つ目の研究では、音響情報と言語情報を別々に分析したうえで統合します。これに対し、2つ目の研究では、すべての手掛かりを1つの大規模言語モデル(LLM)に入力し、総合的な判断を委ねます。では、2つの研究はそれぞれ、声に含まれる認知機能の兆候をどのように読み取ったのでしょうか。
声に表れる2つの手掛かり〜何を話すか、どう話すか〜
認知機能が低下すると、発話には大きく分けて2種類の変化が表れます。
1つ目は、言語的な変化です。言いたい言葉がなかなか出てこず、「あの……ほら、あれ」のような迂回表現が増えたり、「いや、そうではなくて」と途中で言い直すことが多くなったりします。使う語彙が限られ、文の構造が単純になる傾向もみられます。
2つ目は、音響的な変化です。発話中の間が長くなったり、話す速度が遅くなったりと、話の内容ではなく、話し方そのものに変化が生じます。
2つの研究では、こうした変化をモデルが処理できる形に変換しました。言語的な変化については、1つ目の研究でLLMに各文を読み取らせ、語彙の多様性、文法的な完成度、流暢さ、自己修正や不確実性を示す表現の頻度といった言語パターンを評価しました。
2つ目の研究では、音響的な変化のうち、発話速度とポーズを数値化しました。認知機能低下のある群は、ない群よりも発話速度が遅く、1秒当たりの単語数は前者が約2.9語、後者が約3.1語でした。また、0.5秒以上続くポーズで両群の差が最も明確に表れました。誰でも会話中には短い間を置くため、ごく短いポーズは両群を見分けるうえで大きな手掛かりにはなりませんでした。
難しいのは、この2つが性質の異なる情報だという点です。文字起こしでは、ためらいや間の情報が失われます。一方、音声だけでは、語彙や話の組み立て方の変化を捉えにくくなります。2つの研究は、それぞれ異なる方法で両方の手掛かりを生かす手法を提案しました。
研究に使われた絵画描写課題
両研究は、公開データセット「ADReSS」と「ADReSSo」を用いて性能を評価しました。いずれも認知症研究向けに公開された英語音声データセットで、世界各国の研究チームが成果を比較するためのベンチマークとして利用されています。
2020年に公開されたADReSSは、認知機能低下のある参加者とない参加者を同数集め、年齢と性別の分布もそろえた156人規模のデータセットです。モデルが年齢や性別ではなく、発話の違いに基づいて2つの群を識別できるよう設計されています。翌年に公開されたADReSSoでは、規模が237人に拡大しました。提供されるのは音声のみで、研究者は音声認識を使って文字起こしを行う必要があります。
構成には違いがあるものの、どちらのデータセットでも、参加者は同じ絵を見て、その内容を自由に説明します。絵には、キッチンで子どもが椅子の上に立ち、クッキーの入った瓶に手を伸ばす一方、その隣ではシンクから水があふれている様子が描かれています。「クッキー泥棒の絵(Cookie Theft picture)」と呼ばれるものです。
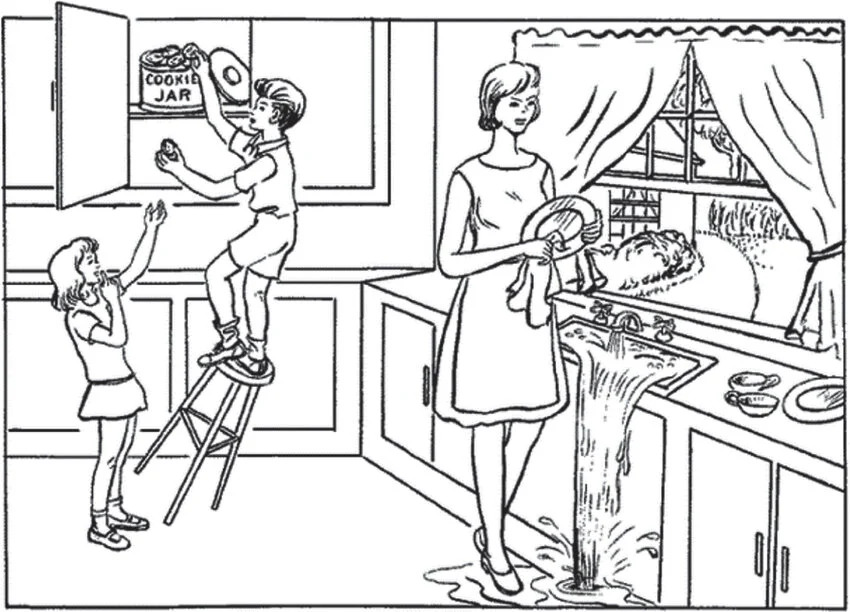
<図1>認知症研究で用いられる「クッキー泥棒の絵」
全員が同じ絵を説明するため、「何に言及したか」「どのような言語パターンで説明したか」「絵の各領域をどの程度幅広く取り上げたか」を参加者間で直接比較できます。
例えば、ある参加者が「子どもが椅子に乗ってクッキーを取ろうとしていて、水があふれています」と場面を筋道立てて説明する一方、認知機能低下のある参加者は「ええと……これは……何だったかな……子どもがいて……」のように、不確かな表現や言い直しが増え、絵全体にまんべんなく触れるのではなく、特定の領域だけを説明する傾向があります。個々の対象に触れたかどうかだけでなく、異なる領域の内容をどれだけ関連付けて説明できているかも比較できます。
【研究1】 行間を聴く〜1つの音声認識モデルに耳と言語感覚を持たせる〜
1本目の論文「Listening Between the Lines」は、OpenAIが公開した音声認識(ASR)モデル「Whisper」を、単なる文字起こしのツールとして使わないという発想から始まりました。
Whisperの内部にあるエンコーダーには、音声をテキストに変換する過程で、最終的なテキストには残らない情報も豊富に含まれています。発音の明瞭さ、イントネーション、リズム、ためらいといった音響的な手掛かりです。この研究では、文字起こしだけでなく、変換の過程で得られる非言語情報も利用します。
研究チームはこの考えに基づき、音響経路、言語経路、2種類の信号をまとめるゲート融合の3つからなる構成を設計しました。
①音響経路:どこに注意して聴くか
まず、Whisperのエンコーダーから得た音響表現を、時系列ニューラルネットワークのBiLSTMで処理します。続いて、アテンションプーリングにより情報を要約します。
アテンションプーリングは、発話を細かく分割した各区間に「分類にどの程度重要か」というスコアを付け、その重みに従って1つの表現にまとめる仕組みです。どの部分を重視するかは人が指定するのではなく、モデルが学習を通じて自ら身につけます。重要な箇所に自動的に「耳を傾ける」仕組みといえます。
②言語経路:LLMが読み取る言語的な兆候
同じ発話から得た文字起こしは、LLMで分析します。語彙の多様性、文法的な完成度、意味の一貫性、話の展開方法など、解釈可能な言語特徴を46種類抽出し、そのうち分類に最も有効な29種類を選んで使用しました。
絵の説明を分析するため、LLMを使って8つのトピックからなる分類体系も自動的に構築しました。従来の研究では、数十年前に人手で作成された採点項目が使われてきました。今回は、人が絵を説明する際に自然とひとまとまりになる話題を、LLM自身にトピック領域として定義させました。
この体系は、子どもの行動やシンクから水があふれる場面など、絵の内容を示す7つの領域と、「ええと……何だったかな……」といった不確かな表現や言い直しを含む1つの「メタ談話」領域で構成されます。
③ゲート融合:2種類の信号を重み付けする
最後に、ゲート融合(gated fusion)ネットワークが音響信号と言語信号を統合します。ゲート融合はサンプルごとに、音響的な手掛かりと言語的な手掛かりのどちらがより信頼できるかを判断し、重みを調整する仕組みです。
音声はWhisperに入力された後、2つの経路へ分かれます。音響経路では、エンコーダー出力に含まれるリズム、イントネーション、ポーズを抽出し、アテンションプーリングで重要な区間に注目します。言語経路では、文字起こし結果をLLMで分析し、29種類の言語特徴を抽出します。両経路の出力をゲート融合で適応的に統合し、認知機能低下の有無を判定します。
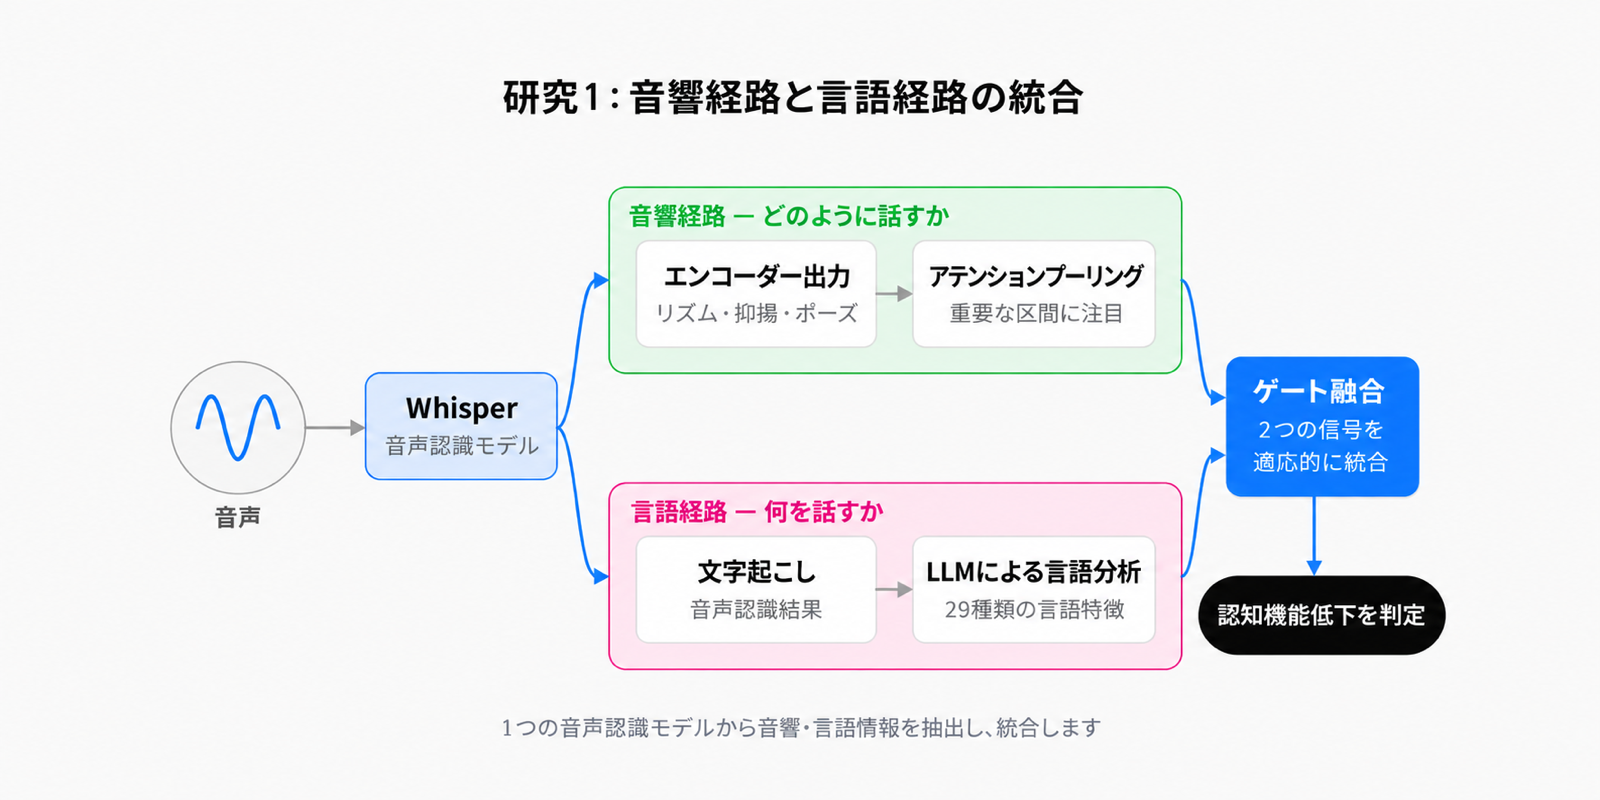
<図2>1つの音声認識モデルから音響情報と言語情報を抽出し、統合する【研究1】の構成
検証結果:F1スコアで従来の最高性能を更新
適合率と再現率を総合した分類性能指標であるF1スコアは、ADReSSで89.47%、ADReSSoで90.14%となりました。特にADReSSoでは、それまでの最高値である87.32%を上回りました。
ADReSSoにおいて、音響情報のみを使用した場合のF1スコアは83.08%、言語情報のみの場合は76.06%でした。両者を融合することで、それぞれ7.1ポイント、14.1ポイント向上しています。「何を話すか」と「どう話すか」が互いに補完し合う手掛かりであることが、数値からも確認されました。
もう1つ、興味深い結果が得られました。統計的に有意な特徴だけを使ったモデルのF1スコアは78.82%にとどまった一方、複数の特徴を併用した際の分類性能を基準に特徴を選別すると、90.14%を記録しました。単独では弱い特徴でも、別の特徴と組み合わせれば強力な信号になり得ることを示しています。
【研究2】 4つの視点を1つのプロンプトにまとめ、LLMに総合判断を委ねる
2本目の論文「LoRA-Tuned Large Language Models for Dementia Detection via Multi-View Speech-Derived Features」は、1つの問いから出発しました。複数のモデルや複雑な統合構造を使わず、1つのLLMですべての手掛かりをまとめて判断できないか、という問いです。
【研究1】を含む従来のアプローチでは、音響モデルとテキストモデルを別々に学習させ、最後に結果を統合する方法が一般的でした。【研究2】では逆に、1つの発話から抽出した4つの視点(view)を1つの構造化プロンプトにまとめ、LLMへ一括して入力します。
1つの発話を4つの視点から捉える
① 文字起こしとポーズ位置:文字起こしした文の中で0.5秒以上のポーズがあった位置に、`<ポーズ>`トークンを挿入します。「道があって、<ポーズ>それから……」というように、テキストを見るだけで、どこでためらったかが分かります。
② 発話フローの統計:1秒当たりの単語数、ポーズの回数、ポーズの平均時間など、発話全体の流れを数値で要約します。
③ 話のトピック情報:【研究1】で紹介した8つのトピック分類体系を使い、それぞれの発話が絵のどの部分を説明しているか、あるいは「何だったかな……」といったメタ談話にとどまっているかをラベル付けします。
④ 音素系列:発音を、音の最小単位である音素レベルで記録します。通常の文字起こしでは、発音が不明瞭でも正しい単語に補正されることがあります。研究では、人が不明瞭な音を文脈によって補いながら理解する仕組みから着想を得た音素認識器「HuPER」を使用しました。不明瞭な発話からも安定して音素を認識し、単語には表れない微細な調音、すなわち口や舌の動きの変化まで取り込みます。
これら4つの視点を1つの構造化プロンプトにまとめ、LoRAで効率的に学習したLLMに入力します。モデルは異なる手掛かりを1回の推論で総合し、認知機能低下の有無を判定します。
LoRAで大規模モデルを効率よく専門化
構造化プロンプトを使ってオープンソースLLMのQwen3およびGemma3系列を学習させる際には、「LoRA(low-rank adaptation)」と呼ばれる効率的な学習手法を採用しました。
LoRAでは、モデル全体を一から学習し直すのではなく、小さなアダプターだけを追加で学習します。家全体を改装する代わりに、必要な部屋へ用途に合った家具だけを入れるようなものです。認知症の音声データは規模が大きくないため、事前学習済みモデルの能力を保ちながら対象タスクに適応させるこの方法が、特に有効です。

<図3>異なる視点から得た手掛かりを1回の推論で統合して判定する【研究2】の構成
複雑な融合構造を使わずF1スコア90.14%を達成
ADReSSoベンチマークにおけるF1スコアは90.14%となり、発表時点で報告されていた最高性能の87.32%を上回りました。【研究1】と同じスコアに、まったく異なるアプローチで到達した
ことになります。独立した音響エンコーダーや複雑な融合構造を使わず、1回の推論でこの性能を達成した点が特徴です。
4つの視点から得た情報を段階的に追加した実験でも、特徴的な結果が得られました。文字起こしだけを使用した場合のF1スコアは81.48%でしたが、話のトピック情報を加えると87.29%まで上昇しました。改善幅は5.81ポイントで、追加した情報の中で最大でした。
さらに、発話フローの統計を加えると1.44ポイント、音素情報を加えると1.41ポイント向上し、最終的に90.14%へ達しました。発話が絵のどのトピックを扱っているかという談話レベルの情報が、認知症の検出に重要であることを示す結果です。
モデルのパラメーター数を約40億(4B)から約140億(14B)へ増やすと、性能も一貫して向上しました。一方、小規模なモデルも既存システムに匹敵する性能を維持しました。
2つの研究が示した共通点
同じ研究チームが提案した、構造がまったく異なる2つのアプローチが、ADReSSoベンチマークでともにF1スコア90.14%に到達しました。一方は2つのニューラルネットワークをゲート融合で統合するモデル、もう一方は4つの視点をプロンプトにまとめ、1つのLLMに判断を委ねるモデルです。
この一致が示唆するのは、性能を左右する鍵が特定のモデル構造ではなく、「何を話すか」と「どう話すか」を同時に読み取ることにあるという点です。実際、両研究の実験では、手掛かりを1つずつ追加するたびに性能が一貫して向上し、いずれか一方の手掛かりだけを使ったモデルとの間には明確な差が生じました。
LLMが音声による認知機能の分析に有用なツールとなり得る点も、両研究に共通しています。人手で作成した採点基準に代わるトピック分類体系の構築、解釈可能な言語特徴の抽出、性質の異なる手掛かりを1回の推論で統合して判断する役割まで、いずれの研究でもLLMが中核を担いました。
ただし、今回は英語の公開データセットを用いた検証であり、この点には限界があります。まず共通の基準で手法の有効性を確かめ、その後、実環境で検証するのが一般的な研究の流れです。研究チームは次の段階として、多言語ベンチマークへの拡張に加え、1種類の絵画描写課題だけでなく、実際のサービスで交わされる多様な話題の会話でも性能を確保するための研究を続ける計画です。
認知機能研究の次のステップ
2本の論文は、オーストラリア・シドニーで開催されたInterspeech 2026で発表されました。
NAVER Cloudはこれまで、「CLOVA CareCall」を通じて、AIが高齢者に電話をかけて安否を確認するサービスを提供してきました。今回の研究は、こうした会話を単なる安否確認にとどめず、認知機能低下の初期兆候まで捉えるセーフティーネットへ発展させるための技術的基盤となります。
精密検査のために医療機関を受診するハードルは、依然として低くありません。その前段階で、電話による日常会話から初期兆候を捉え、必要な人をより早く専門医の診療につなげることが目標です。
すでに最初の取り組みも始まっています。NAVER Cloudは、認知症デジタルソリューションを手掛けるスタートアップのイモコグ(Emocog)と共同で、ソウル特別市ボラメ病院において、電話による認知機能検査の臨床研究を進めています。CareCallからの1本の電話で認知機能を確認できる仕組みの実現に向け、検証を重ねています。
短い安否確認の電話を、高齢者の健康を守る最初のセーフティーネットにする。NAVER Cloudは、音声AI技術でその実現を目指しています。
※本記事で紹介した2つの研究は研究段階の成果であり、医師による診断を代替するものではありません。
【論文情報】
Listening Between the Lines: Joint Learning of ASR Embeddings and LLM-Augmented Linguistics for Dementia Detection
Olivier Jiyoun Jung, Jonghyeon Park, Myungwoo Oh
https://arxiv.org/abs/2606.30675
LoRA-Tuned Large Language Models for Dementia Detection via Multi-View Speech-Derived Features
Jonghyeon Park, Olivier Jiyoun Jung, Myungwoo Oh

関連ニュース
 2025.07.25 「NAVER CareCall」、認知症のある高齢者の記憶機能と抑うつ症状に有益な変化